
神经网络平衡
引言:从“训练不稳定”到“平衡”视角编辑本段
深度神经网络的成功不仅依赖于强大的表达能力,更依赖于优化过程的可控性。在训练深层网络时,研究者很早就观察到:若初始化不当,信号在前向传播中会指数级放大或衰减;反向传播时,梯度也会指数级消失或爆炸。这些现象本质上是网络内部统计量失衡的体现。近年来,“平衡”逐渐成为一个统摄性概念,用以描述网络在激活、梯度、权重范数以及类别预测等多个维度上处于稳定、可协调的状态。神经网络平衡并非一个单一指标,而是一组相互关联的约束条件,它们共同决定了网络能否被高效优化并泛化到未见数据。
激活值平衡:前向信号的可控传播编辑本段
激活值平衡关注的是前向传播中各层神经元输出的分布。理想情况下,每一层的激活值应具有零均值(或在零附近)、适中的方差,且不随层数加深而系统性漂移。若激活值方差过大,网络会进入饱和区(如Sigmoid或Tanh的饱和段),梯度趋近于零;若方差过小,则信号逐层衰减,深层神经元几乎不响应输入。He初始化与Xavier初始化正是基于这一平衡思想:根据层类型和激活函数特性,调整初始权重的方差,使前向传播时激活值的方差在各层间大致保持不变。批归一化(Batch Normalization)则通过在每个小批量上对激活值进行标准化,强制其均值为0、方差为1,从而在训练过程中动态维持激活平衡。层归一化(Layer Normalization)和组归一化(Group Normalization)进一步将其推广到循环网络和小批量场景。
梯度平衡:反向信号的稳定回传编辑本段
梯度平衡是激活平衡在反向传播中的对偶问题。反向传播时,梯度从输出层逐层回传,每一层都会乘以该层权重的雅可比矩阵。若这些矩阵的奇异值普遍大于1,梯度会指数增长(爆炸);若普遍小于1,梯度会指数衰减(消失)。梯度平衡的目标是使梯度范数在各层间保持合理比例,既不致溢出也不致消失。残差连接(Residual Connection)通过引入恒等映射,为梯度提供了一条直接回传的通路,有效缓解了深层网络中的梯度消失问题。梯度裁剪(Gradient Clipping)则在上界上施加约束,防止梯度爆炸。此外,正交初始化、谱归一化(Spectral Normalization)等技术通过控制权重矩阵的谱性质来维持梯度平衡。
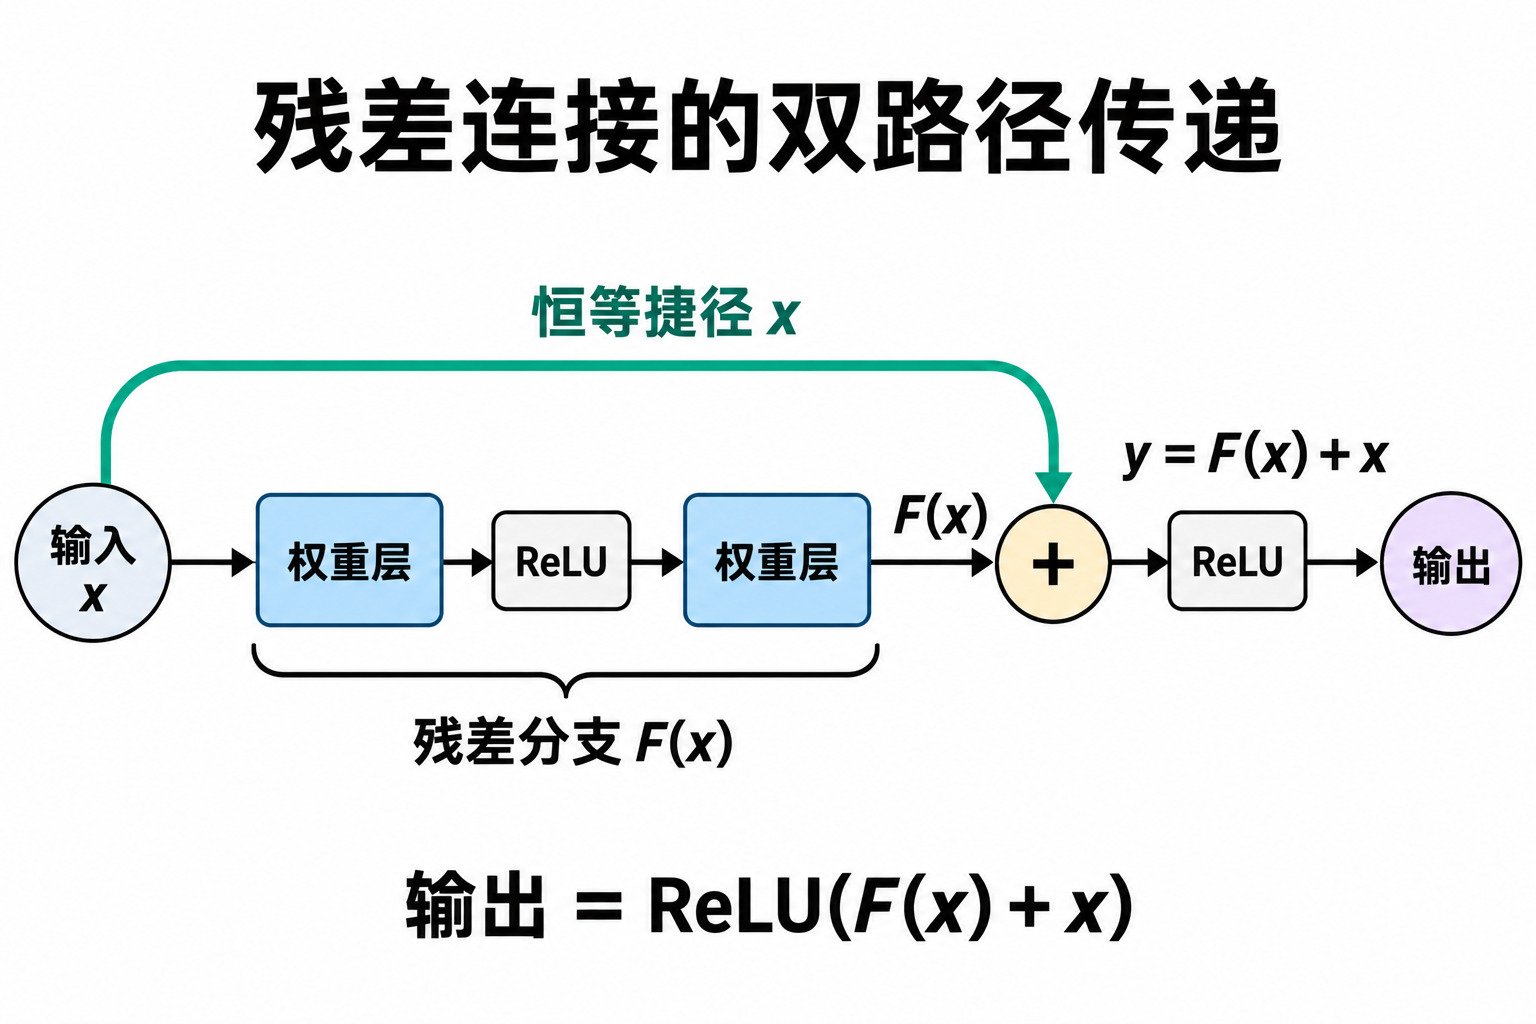 输入x同时经过残差分支和恒等捷径,在加号节点与F(x)逐元素相加,再经过ReLU得到输出。绿色箭头表示恒等捷径,黑色箭头表示残差分支和输出方向。
权重范数平衡与优化动力学编辑本段
权重范数平衡关注的是不同层或不同神经元权重范数的相对大小。在训练过程中,若某些层的权重范数远大于其他层,会导致有效学习率失衡:范数大的层更新步长相对较小,范数小的层更新步长相对较大,从而破坏各层协同学习的节奏。权重衰减(Weight Decay)和AdamW优化器中的解耦权重衰减机制,通过正则化项约束权重范数,防止其无界增长。此外,权重范数平衡与网络的隐式正则化密切相关:在过参数化网络中,梯度下降倾向于寻找范数较小的解,这种隐式偏置有助于泛化。因此,维持权重范数平衡不仅是优化稳定性的需要,也是泛化性能的保障。
类别预测平衡:输出层的公平性与校准编辑本段
在分类任务中,神经网络平衡还涉及输出层各类别预测概率的平衡。若训练数据存在类别不平衡,网络会倾向于预测多数类,导致少数类的召回率低下。更重要的是,即使数据平衡,网络也可能出现“过度自信”或“欠自信”的校准问题,即预测概率与真实准确率不匹配。类别预测平衡的目标是使网络对各类别的预测置信度合理反映其真实正确率,并避免对某些类别的系统性偏见。焦点损失(Focal Loss)通过降低易分类样本的权重,缓解类别不平衡;标签平滑(Label Smoothing)则通过软化目标分布,防止网络对单一类别过度自信,从而改善校准。温度缩放(Temperature Scaling)作为后处理手段,可在不改变预测类别的前提下调整预测概率的平衡性。
内部协变量偏移:平衡问题的历史视角编辑本段
内部协变量偏移(Internal Covariate Shift)是批归一化论文中提出的概念,指训练过程中由于前层参数更新导致后层输入分布发生变化,从而迫使后层不断适应新的分布。这一概念曾被视为深层网络难以训练的重要原因,并推动了归一化技术的普及。尽管后续研究对此提出质疑,认为批归一化的有效性更多源于其对损失函数 landscape 的平滑作用,而非单纯减少内部协变量偏移,但这一讨论深化了人们对网络平衡机制的理解。无论如何,保持各层输入分布的相对稳定,仍然是维持网络平衡的重要工程原则。
平衡与泛化:双下降与边缘现象编辑本段
近年来,关于神经网络平衡的研究开始与泛化理论交织。经典偏差-方差权衡认为模型复杂度增加会导致泛化先改善后恶化,但深度网络表现出“双下降”现象:当模型参数量超过插值阈值后,测试误差反而再次下降。这一现象提示,过参数化网络可能通过维持某种隐式平衡(如权重范数平衡、特征秩平衡)来实现泛化。此外,神经网络在训练后期常出现“边缘现象”(Edge of Stability),即最大特征值在稳定边缘附近波动,此时损失函数呈现非单调但整体下降的趋势。这些发现表明,平衡并非静态的固定点,而是一种动态的、临界的状态,优化过程在稳定与不稳定之间寻求折中。
平衡的度量与调控编辑本段
在实践中,研究者开发了多种度量网络平衡性的指标,包括各层激活值的均值与方差、梯度范数逐层分布、权重矩阵的谱范数、特征表示的秩以及预测概率的校准误差等。基于这些度量,可以设计自适应调控策略,如动态调整归一化参数、引入平衡正则项、或采用分层学习率。值得注意的是,过度追求某一维度的平衡可能损害其他维度,因此需要权衡。例如,过强的权重衰减虽能控制范数平衡,却可能削弱模型容量。因此,神经网络平衡的工程实践强调多目标协调与适度原则。
结论与展望编辑本段
附件列表
词条内容仅供参考,如果您需要解决具体问题
(尤其在法律、医学等领域),建议您咨询相关领域专业人士。